AI Hallucination क्या है? चैटबॉट गलत जवाब क्यों देता है
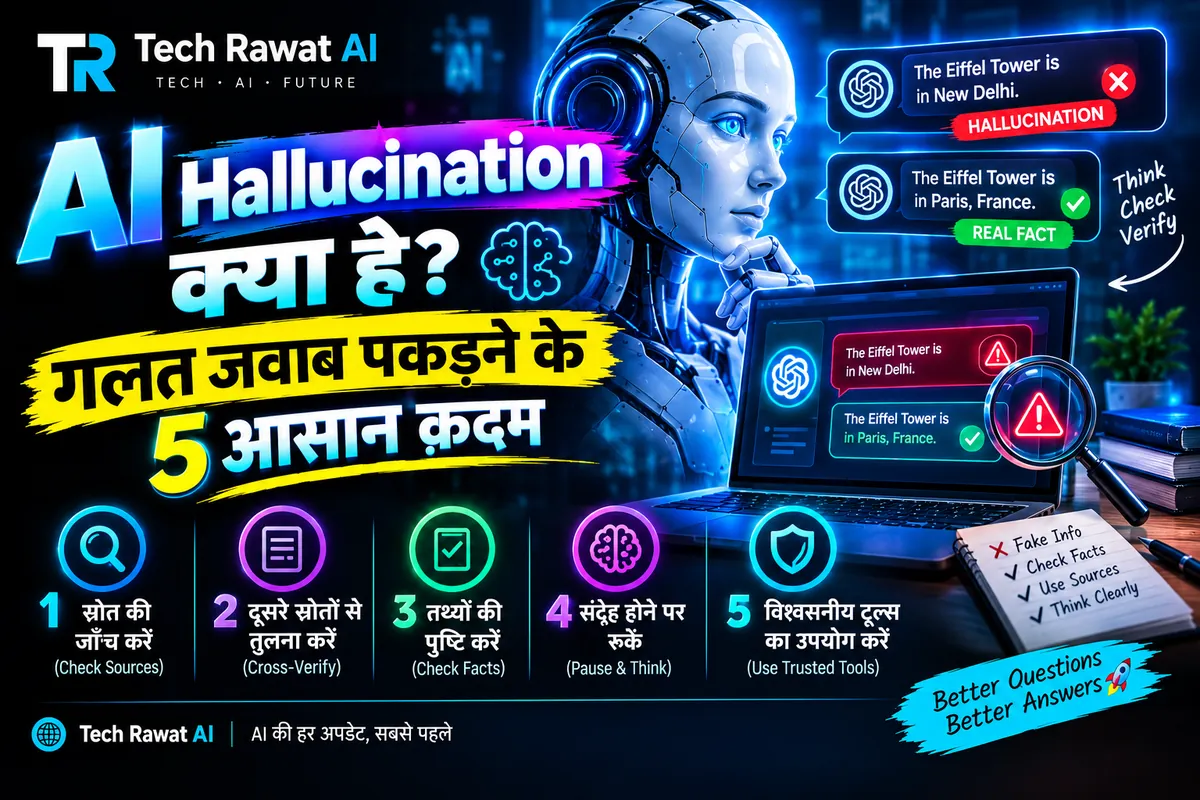
AI Hallucination वह स्थिति है जब चैटबॉट पूरे भरोसे के साथ ऐसा जवाब देता है जो सुनने में सही लगता है, पर असल में गलत या गढ़ा हुआ होता है। चैटबॉट तथ्य जाँचकर नहीं, अगला सबसे संभावित शब्द चुनकर लिखता है, इसलिए नाम, तारीख, आँकड़े और हवाले सबसे ज़्यादा बिगड़ते हैं।
जब वकीलों ने AI के गढ़े मुक़दमे अदालत में जमा कर दिए
22 जून 2023 को न्यूयॉर्क की संघीय अदालत (मैनहैटन) के जज पी. केविन कैस्टल ने एक वकील फ़र्म और उसके दो वकीलों पर $5,000 का जुर्माना लगाया। Bloomberg Law की उसी दिन की ख़बर के अनुसार, अदालत में जमा दस्तावेज़ में ChatGPT के बनाए ऐसे फ़ैसलों के हवाले थे जो असल में कभी दिए ही नहीं गए थे।
जज के लिखित आदेश के मुताबिक वकीलों ने बनावटी फ़ैसले और नकली उद्धरण अदालत में रखे, और अदालत के सवाल उठाने के बाद भी उन्हीं फ़ैसलों पर टिके रहे। जज ने उन्हें अपना आदेश उन सभी जजों को भेजने का भी निर्देश दिया, जिनके नाम छह फ़र्ज़ी फ़ैसलों में लेखक बताकर लिखे गए थे।
इस मामले की सीख किसी तकनीकी शब्द में नहीं, एक सीधी बात में है: जवाब जितना पक्का और क़ानूनी भाषा में सजा हुआ दिखे, उसे उतने ही ध्यान से खुद जाँचना पड़ता है।
AI Hallucination क्यों होती है? OpenAI का जवाब
OpenAI ने 5 सितंबर 2025 को अपने पेज पर बताया कि भाषा मॉडल दो वजहों से गलत बातें गढ़ते हैं। पहली वजह पूर्व-प्रशिक्षण में है। मॉडल विशाल पाठ में अगला शब्द अनुमान लगाना सीखता है, और उसे सिर्फ़ सही-सुनने वाले वाक्यों के उदाहरण मिलते हैं, किसी वाक्य पर सच या झूठ का ठप्पा नहीं। वर्तनी और कोष्ठक जैसे नियमित पैटर्न की गलतियाँ पैमाना बढ़ने पर ख़त्म हो जाती हैं, पर किसी पालतू जानवर की जन्मतिथि जैसी मनमानी और कम दिखने वाली बातें पैटर्न से निकाली ही नहीं जा सकतीं, इसलिए वहाँ अंदाज़ा लगता है।
दूसरी वजह परीक्षा के तरीके में है। बहुविकल्पीय पेपर में खाली छोड़ने पर शून्य मिलता है और तुक्का लगाने पर कभी-कभी अंक, इसलिए तुक्का लगाने वाला विद्यार्थी फ़ायदे में रहता है। OpenAI के मुताबिक ज़्यादातर मॉडल-जाँच सिर्फ़ सही जवाबों का प्रतिशत गिनती हैं, इसलिए मॉडल “पता नहीं” कहने की जगह अंदाज़ा लगाना सीखते हैं।
OpenAI ने एक सीधा उदाहरण भी दिया। उसने एक जाने-माने चैटबॉट से अपने ही एक शोध-लेखक की पीएचडी थीसिस का शीर्षक पूछा, तो तीन अलग-अलग जवाब मिले और तीनों गलत थे। जन्मतिथि पूछने पर भी तीन अलग तारीख़ें आईं, तीनों गलत। जनरेटिव AI की बुनियाद शुरू से समझनी हो तो जनरेटिव AI क्या है वाला लेख देखिए।
सबसे साफ़ तस्वीर OpenAI की इस तालिका में दिखती है, जो उसके GPT-5 सिस्टम कार्ड की SimpleQA जाँच से ली गई है:
| मापदंड | gpt-5-thinking-mini | OpenAI o4-mini |
|---|---|---|
| जवाब देने से परहेज़ (पक्का न हो तो) | 52% | 1% |
| सही जवाब | 22% | 24% |
| गलत जवाब | 26% | 75% |
पुराना o4-mini सही जवाबों में थोड़ा आगे रहा (24% बनाम 22%), पर लगभग हर सवाल का जवाब देने की आदत से उसके गलत जवाब तीन गुना के क़रीब (75% बनाम 26%) हो गए। यानी ज़्यादा सही दिखने वाला मॉडल ज़्यादा गलत भी हो सकता है। ये आँकड़े OpenAI के अपने मापन के हैं और एक ही जाँच के हैं। ये जानकारी 20 अक्टूबर 2026 तक की है; मॉडल बदलने पर संख्याएँ बदल सकती हैं, पर अंदाज़ा लगाना ही फ़ायदे का सौदा बन जाए तो गलत जवाब बढ़ते हैं, यह सिद्धांत वही रहता है।
चैटबॉट के दिए कारण और हवाले भी गढ़े हुए हो सकते हैं
अमेरिका की सरकारी संस्था NIST (नेशनल इंस्टीट्यूट ऑफ़ स्टैंडर्ड्स एंड टेक्नोलॉजी) ने 25 जुलाई 2024 को अपने जनरेटिव AI प्रोफ़ाइल (NIST AI 600-1) को मंज़ूरी दी। इसमें हैलुसिनेशन को “कन्फ़ैब्युलेशन” कहा गया है, यानी पूरे भरोसे से पेश की गई गलत या झूठी सामग्री। बोलचाल में इसे हैलुसिनेशन या गढ़ंत भी कहते हैं।
NIST के मुताबिक यह मॉडल की बनावट का स्वाभाविक नतीजा है: मॉडल प्रशिक्षण-सामग्री के आँकड़ों जैसा लिखता है, इसलिए कभी सही और कभी गलत या अंदर से बेमेल बात निकल सकती है। यह जोखिम खुले, लंबे जवाबों वाले सवालों में और ऐसे क्षेत्रों में ज़्यादा है जहाँ गहरी विशेषज्ञता चाहिए।
सबसे काम की बात इसके आगे है। NIST लिखता है कि चैटबॉट जवाब को सही ठहराने वाले तर्क और हवाले भी गढ़ सकता है, जिससे लोग उस पर और ज़्यादा भरोसा कर बैठते हैं। उसके मुताबिक कई बार चैटबॉट गलत जवाब तक पहुँचने के तर्कसंगत लगने वाले चरण भी बता देता है। इसलिए “आपने यह कैसे निकाला?” पूछकर मिला स्पष्टीकरण जाँच का सबूत नहीं है।
किन सवालों में सबसे ज़्यादा सावधानी रखें
सारे जवाब बराबर जोखिम वाले नहीं होते। OpenAI और NIST के ब्योरों के आधार पर ये चार तरह की बातें सबसे पहले जाँचने लायक हैं:
| बात का प्रकार | जोखिम की वजह | आपका काम |
|---|---|---|
| जन्मतिथि, थीसिस का शीर्षक, छोटे आँकड़े | OpenAI के अनुसार कम दिखने वाली मनमानी बातें सिर्फ़ पैटर्न से नहीं निकल सकतीं | भरोसेमंद स्रोत से मिलाइए |
| अदालती फ़ैसले, क़ानून की धाराएँ | NIST ने क़ानूनी मामलों में ऐसी गढ़ंत को व्यापक बताया है, और 22 जून 2023 का मामला इसका उदाहरण है | फ़ैसले का नाम और संख्या अदालत या सरकारी पोर्टल पर खुद खोजिए |
| किताब, शोध पत्र या वेब पते के हवाले | NIST के अनुसार हवाले और तर्क भी गढ़े जा सकते हैं | हर हवाला खुद खोलिए, न मिले तो उस पर भरोसा मत कीजिए |
| सेहत से जुड़ा सारांश या सलाह | NIST का उदाहरण: मरीज़ की रिपोर्ट का गढ़ा सारांश डॉक्टर को गलत निदान की ओर ले जा सकता है | इलाज का फ़ैसला डॉक्टर से, और सारांश को मूल रिपोर्ट से मिलाइए |
चैटबॉट का गलत जवाब कैसे पहचानें: 5 क़दम की जाँच
ये पाँच क़दम किसी भी चैटबॉट पर लागू होते हैं और कुछ ही मिनट में हो जाते हैं।
- दावे चुनिए: जवाब में से तीन ऐसी बातें अलग लिखिए जिन्हें जाँचा जा सके: एक नाम, एक तारीख या संख्या, और एक हवाला।
- हवाला खुद खोलिए: किताब, शोध पत्र या फ़ैसले का नाम चैटबॉट के बाहर, किसी खोज इंजन या आधिकारिक वेबसाइट पर अलग से खोजिए। वह मिले ही नहीं तो उस पर भरोसा मत कीजिए।
- जाँच चैटबॉट से बाहर रखिए: उसी चैटबॉट से “क्या यह सही है?” पूछना जाँच नहीं है, क्योंकि NIST के अनुसार उसके तर्क और हवाले भी गढ़े हुए हो सकते हैं।
- सवाल दोबारा पूछिए: दूसरी बातचीत में वही सवाल अलग शब्दों में पूछिए। OpenAI के उदाहरण में जन्मतिथि पर तीन अलग तारीख़ें आई थीं। हर बार जवाब बदले तो मान लीजिए कि मॉडल को पक्का पता नहीं।
- बड़े फ़ैसले की पुष्टि कीजिए: पैसे, सेहत या क़ानून से जुड़ी बात हो तो आधिकारिक वेबसाइट या विशेषज्ञ से पुष्टि कीजिए, और तब तक उस पर काम आगे मत बढ़ाइए।
चैटबॉट को “पता नहीं” कहने की छूट दीजिए
OpenAI का तर्क है कि मॉडल अनिश्चित होने पर पीछे हट सकते हैं, और उसकी अपनी नीति कहती है कि गलत हो सकने वाली बात भरोसे से कहने से बेहतर है अनिश्चितता बताना। इसलिए सवाल के साथ यह लाइन जोड़कर इस्तेमाल करके देखिए:
अगर तुम्हें किसी बात का पक्का पता नहीं है तो साफ़ लिखो “मुझे पक्का पता नहीं”। नाम, तारीख और आँकड़े बिना भरोसेमंद स्रोत के मत देना, और हर हवाले के साथ बताओ कि मैं उसे कहाँ खोलकर जाँच सकता हूँ।
यह प्रॉम्प्ट जोखिम को ख़त्म नहीं करता। OpenAI खुद लिखता है कि GPT-5 में हैलुसिनेशन काफ़ी कम हैं, पर बने रहते हैं।
हिंदी या भारतीय सवाल पूछते समय क्या ध्यान रखें
NIST ने अपने जनरेटिव AI प्रोफ़ाइल में लिखा है कि कोई भाषा मॉडल अंग्रेज़ी के अलावा दूसरी भाषाओं या बोलियों में कमज़ोर प्रदर्शन कर सकता है, और सभी समूहों के लिए एक जैसे प्रदर्शन का भरोसा कर लेना ग़लत हो सकता है। इसलिए हिंदी में पूछे गए सवालों के जवाब पर भी ऊपर की जाँच ज़्यादा सख़्ती से कीजिए।
ख़ास तौर पर सरकारी योजना की पात्रता, आवेदन की शर्तें या तारीख़ चैटबॉट से पूछकर आवेदन मत कीजिए। जवाब में मिला योजना का नाम पहले योजना के अपने आधिकारिक पेज पर खोलिए। इसका पूरा तरीका हमारे myScheme पर सही योजना खोजने के क़दम वाले लेख में है, जहाँ चैटबॉट के बताए नाम को योजना के पेज से मिलाने की बात भी आती है।
हैलुसिनेशन के बारे में तीन आम गलतफ़हमियाँ
- “यह सिर्फ़ ChatGPT में होती है”: OpenAI खुद लिखता है कि ChatGPT भी हैलुसिनेशन करता है और यह सभी बड़े भाषा मॉडल के लिए बुनियादी चुनौती है। GPT-5 में ये काफ़ी कम हैं, ख़ासकर तर्क करते समय, पर होते हैं।
- “सटीकता बढ़ेगी तो यह ख़त्म हो जाएगी”: OpenAI के मुताबिक सटीकता कभी 100% नहीं होगी, क्योंकि कुछ असली सवालों के जवाब तय ही नहीं किए जा सकते। रास्ता यह है कि मॉडल अनिश्चित होने पर पीछे हटे।
- “चैटबॉट जानबूझकर झूठ बोलता है”: NIST इसे मॉडल की बनावट का स्वाभाविक नतीजा बताता है। मॉडल पैटर्न से अनुमान लगाता है और वही अनुमान कभी-कभी गलत निकल जाता है।
अगली बार चैटबॉट कोई नाम, तारीख या हवाला दे, तो सबसे पहले दूसरा क़दम कीजिए: हवाले को चैटबॉट से बाहर खोलकर देखिए कि वह सच में मौजूद है या नहीं। इस लेख के दावे OpenAI के 5 सितंबर 2025 के पेज, NIST AI 600-1 और अदालत के 22 जून 2023 के आदेश पर आधारित हैं, और ये जानकारी 20 अक्टूबर 2026 तक की है।